Reddit Archive
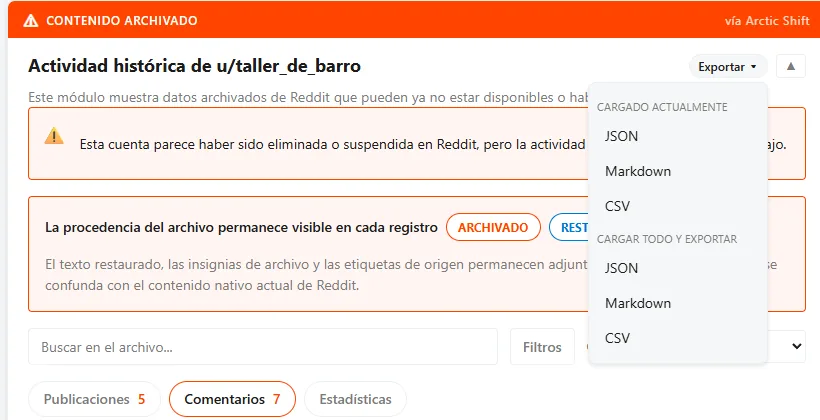
Extensión de Chrome que recupera, desde el archivo público de Arctic Shift, los posts y comentarios borrados o editados de Reddit y los muestra dentro de la propia página, siempre marcados como archivados. Perfiles, posts con su árbol de comentarios, estadísticas por subreddit y exportación de toda la actividad de un usuario a JSON, Markdown o CSV. No pide nada hasta que pulsas el botón.
- endpoints de Arctic Shift
- 11
- endpoints de Arctic Shift
- formatos de exportación
- 3
- formatos de exportación
- idiomas
- 3
- idiomas
- tests (Vitest y Playwright)
- 494
- tests (Vitest y Playwright)
Qué hace
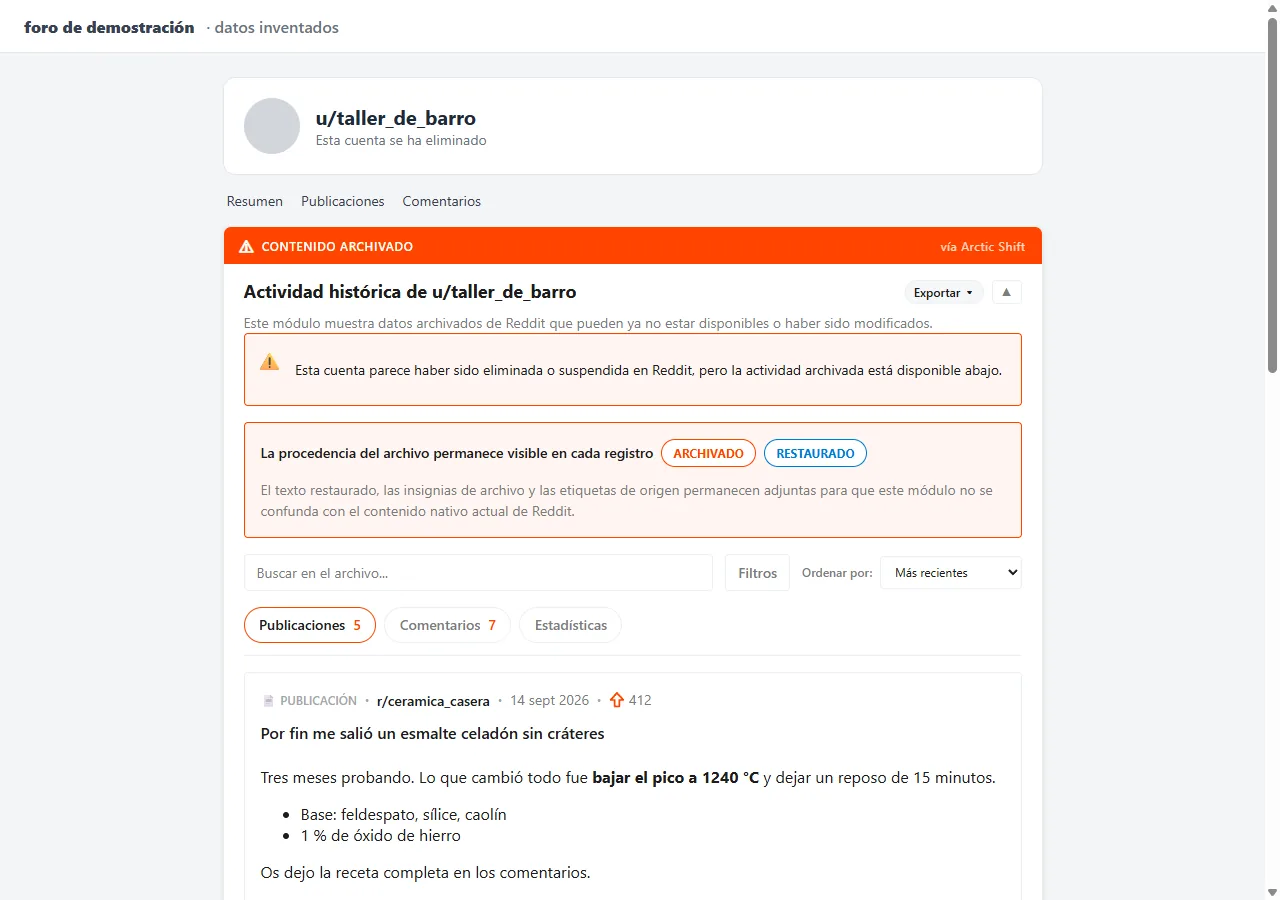
- Lo borrado, de vuelta. En el perfil de cualquier usuario, un botón trae sus publicaciones y comentarios del archivo de Arctic Shift, incluidos los que ya no están en Reddit o los que se editaron después.
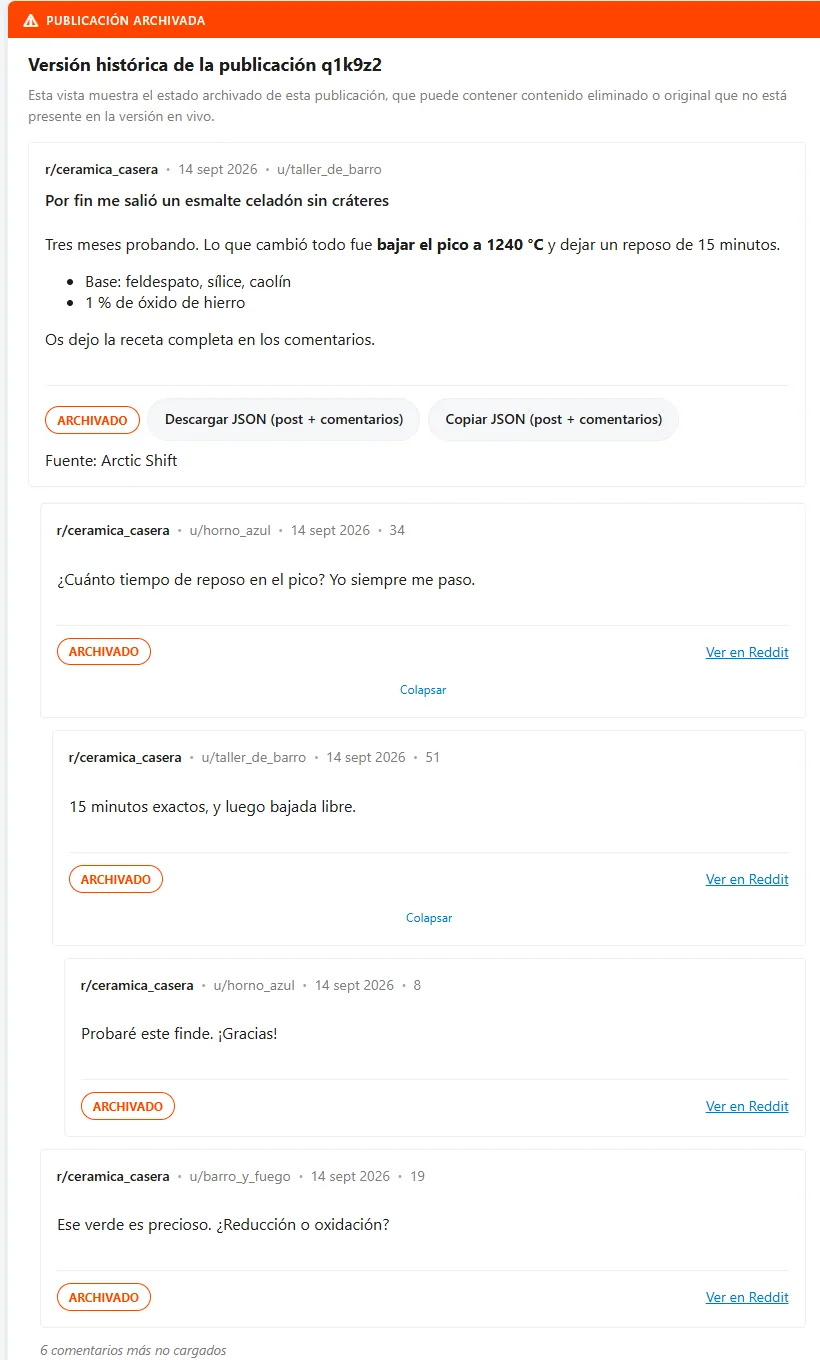
- Posts completos. En la página de un post borrado muestra el título y el texto originales y, si quieres, todo el árbol de comentarios. También funciona con los enlaces cortos
/s/de la app. - Exportar a un usuario. Lo cargado o toda la actividad del usuario, página a página, a JSON, Markdown o CSV. Un post con sus comentarios se descarga o se copia en JSON.
- Buscar y filtrar. Búsqueda en el texto, filtros por subreddit y fechas, y orden por más recientes, más antiguos o puntuación.
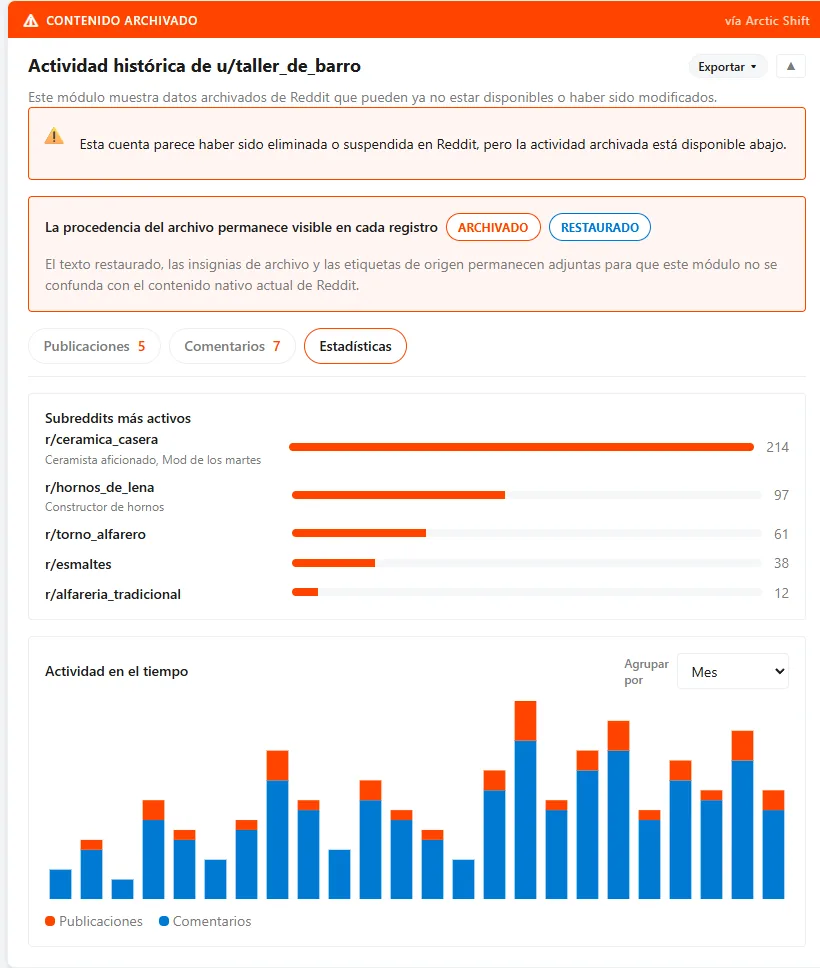
- Estadísticas. Subreddits donde más participa, sus flairs en cada uno y un gráfico de actividad por día, semana, mes o año. Al pasar por encima de un subreddit, su descripción, suscriptores y normas.
- Sin confusiones. Todo lo que viene del archivo va en un panel propio con la etiqueta "Archivado" y la fuente. Lo nativo de Reddit no se toca. Si la cuenta está eliminada o suspendida, lo avisa.
- Solo cuando lo pides. No hace ninguna petición al archivo hasta que pulsas Ver archivo, salvo que actives la carga automática. Sin telemetría ni servidores propios. Español, inglés y chino.
Cómo está hecho
Un cliente para una API que no controlas
Toda la información sale de Arctic Shift, un archivo público de Reddit. Cada respuesta se valida antes de usarla: primero la forma del sobre, luego cada elemento, y después Zod la normaliza a un modelo propio con la procedencia marcada. Los errores no se lanzan: son resultados tipados (http, timeout, schema, not_found…) que la interfaz traduce a un mensaje.
Background, caché en dos niveles y rate limit
Las búsquedas pasan del content script al service worker por mensajes. Hay una caché en memoria por pestaña y otra en chrome.storage.session con caducidad, que solo guarda respuestas correctas. El cliente lee las cabeceras de rate limit y, si quedan pocas peticiones, espera antes de lanzar la siguiente.
Un panel en Shadow DOM encima de una SPA
El panel es una app de Vue 3 montada en un shadow root encima del feed. Un MutationObserver lo vuelve a montar si Reddit repinta la página, y otro sigue su tema claro u oscuro.
Problemas que resolví
- "Más antiguos" que no lo era. Ordenaba solo lo ya cargado, que eran las páginas más recientes. Ahora se pide al servidor en orden ascendente y se pagina hacia delante con un cursor.
- Detectar cuentas borradas. El aviso buscaba palabras como "suspended" en el texto de la página y saltaba con cualquier comentario que las tuviera. Ahora se pregunta a Reddit por
about.json. - HTML de terceros. El Markdown archivado se convierte con marked y se limpia con DOMPurify, quitando también los estilos, porque un
position: fixedpodía tapar la página entera. - CSV que se ejecuta. Un comentario que empieza por
=se convierte en una fórmula al abrir el CSV en una hoja de cálculo. Las columnas de texto se protegen, pero no las numéricas, para no romper puntuaciones negativas.