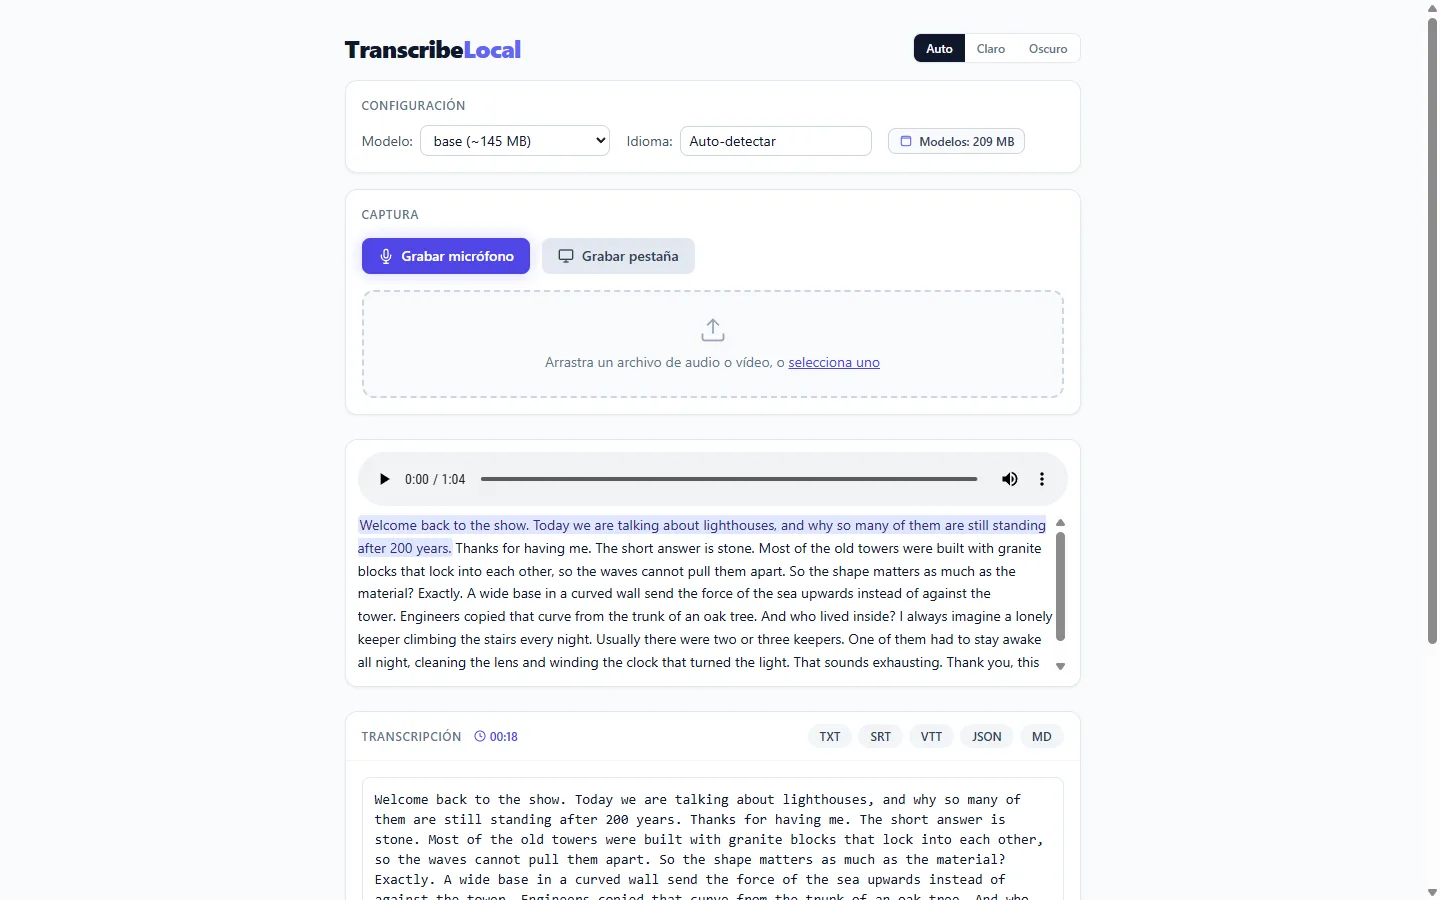
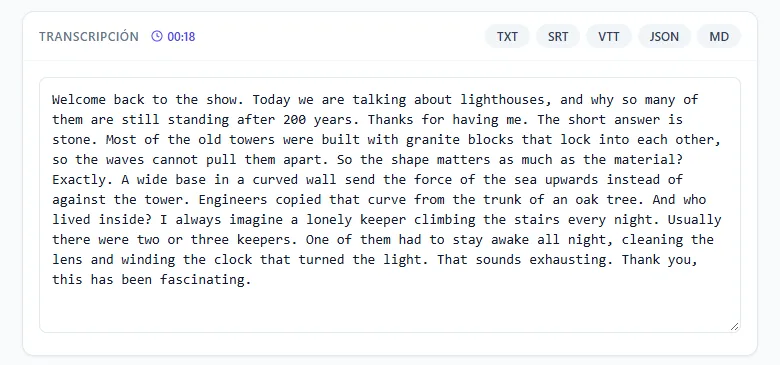
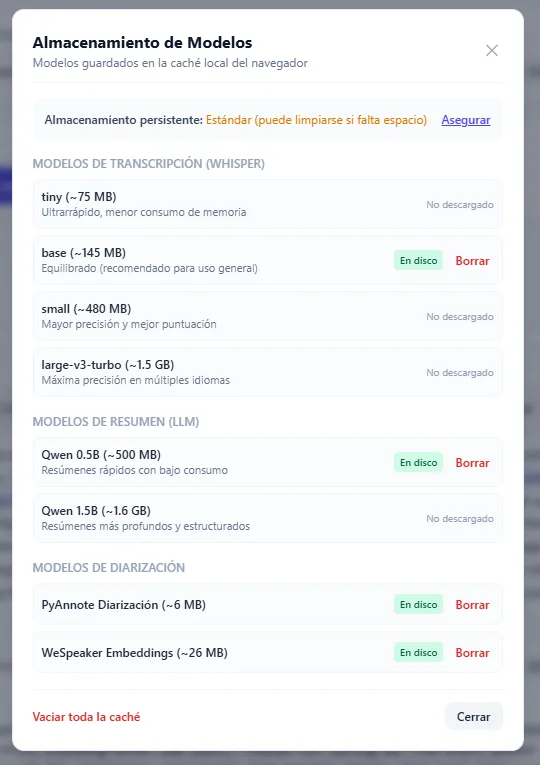
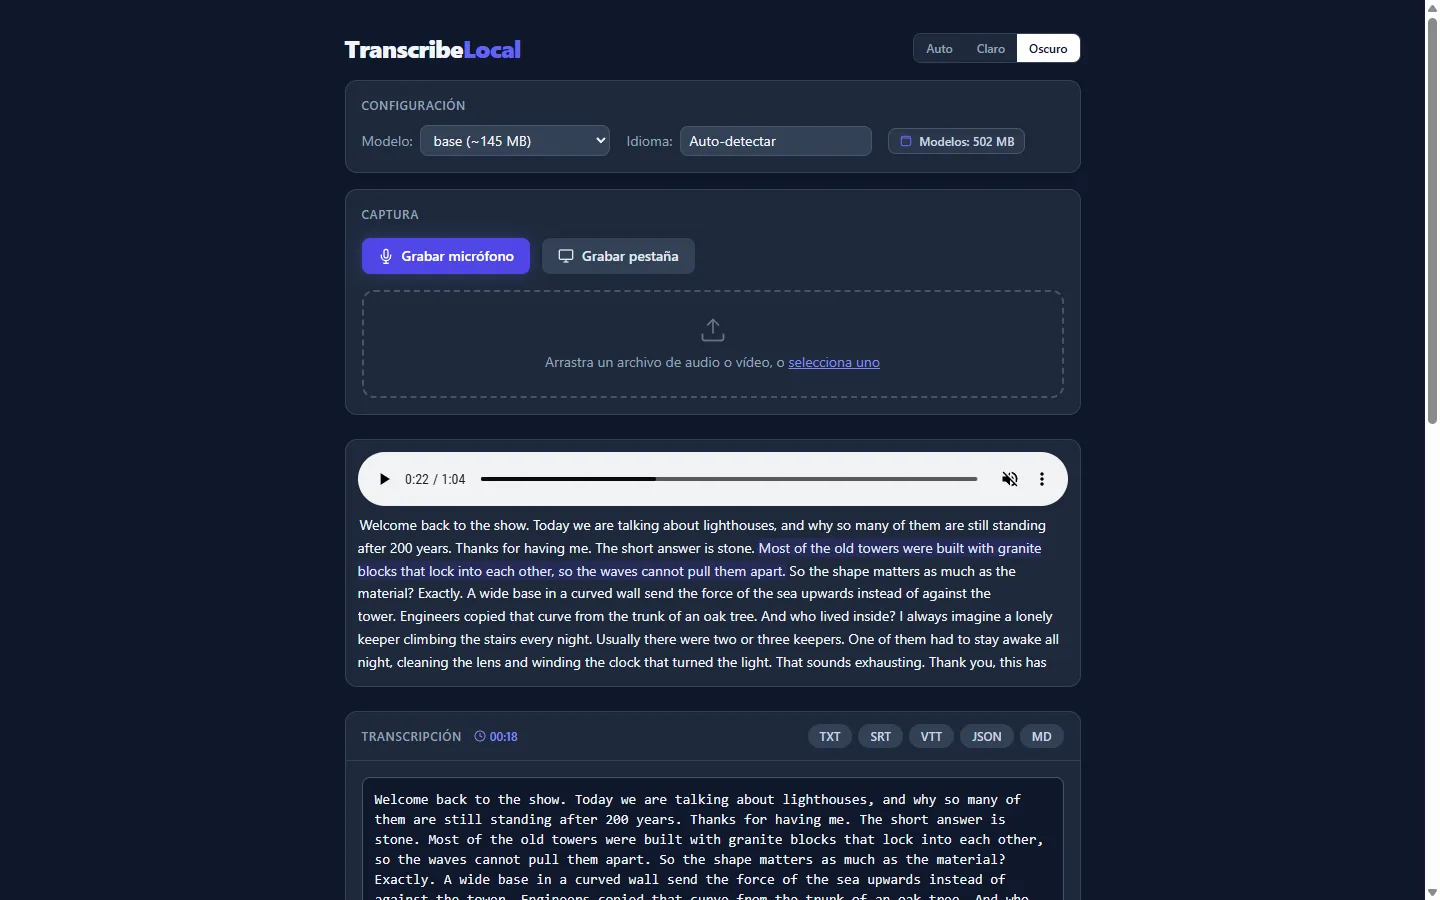
- Transcribir audio y vídeo. Arrastras un archivo y Whisper lo convierte en texto con marcas de tiempo, con el modelo que elijas: de tiny (~75 MB) a large-v3-turbo (~1,5 GB).
- Cien idiomas. Detecta el idioma solo o se lo indicas tú.
- Subtítulos listos. Exporta a SRT y VTT, con cada frase en su tiempo, y también a TXT, JSON y Markdown.
- Reproductor sincronizado. Mientras suena el audio se resalta la frase que se está diciendo, y al pulsar una frase salta a ese momento.
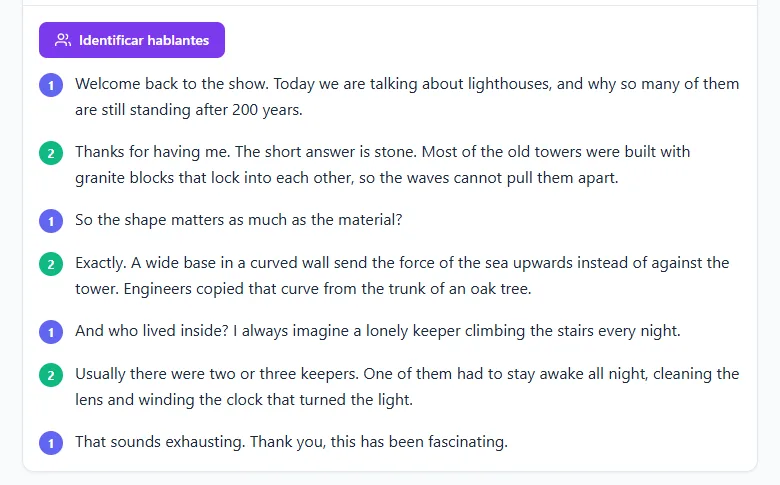
- Quién habla. Separa la transcripción por hablantes (Hablante 1, Hablante 2…).
- Resumen. Un modelo de lenguaje pequeño, Qwen2.5, lo resume sin salir del equipo.
- Grabar. Desde el micrófono o desde el audio de otra pestaña del navegador.
- Modelos bajo control. Se descargan una vez, se quedan en el navegador y un gestor enseña cuánto ocupan y deja borrarlos.
- Instalable y sin conexión. Es una PWA: una vez descargados los modelos, funciona sin internet.
Transformers.js ejecuta los modelos en formato ONNX con WebGPU si hay GPU, y con WebAssembly si no. Cada tarea (transcribir, separar hablantes, resumir) va en su propio Web Worker, así que la interfaz no se congela aunque el modelo tarde.
El audio se decodifica con la Web Audio API, se mezcla a mono y se remuestrea a 16 kHz, que es lo que espera Whisper. Los audios de más de 30 segundos se transcriben en trozos de 30 segundos que se solapan 5.
pyannote-segmentation-3.0 recorre el audio en ventanas de 10 segundos y marca dónde habla cada voz. WeSpeaker convierte cada intervención en un vector. Un agrupamiento propio por similitud del coseno decide qué vectores son la misma persona en todo el audio.
- Whisper se inventaba frases en los silencios. El audio prácticamente mudo o de menos de un cuarto de segundo ya no llega al modelo, y en los audios cortos no se trocea, porque el relleno de silencio provocaba bucles de texto repetido.
- Los audios largos se cortaban a los 30 segundos. Sin trocear, el extractor de características de Whisper descarta todo lo que pasa de ahí sin avisar.
- Alucinaciones en WebGPU. El codificador de Whisper necesita fp32 para no inventar texto en otros idiomas, mientras que el decodificador va en q4 para no agotar la memoria.
- Resúmenes sin sentido. Con el modelo cuantizado en q8, WebGPU devolvía una mezcla de idiomas y fragmentos de código. Ahora va en q4 en WebGPU y en q8 en WebAssembly.
- Descargas que se cortaban a los 5 minutos. El service worker de la PWA interceptaba las descargas de los modelos, y Chrome corta un service worker que tarda más de 5 minutos en responder. Ahora los modelos van directos a la caché de Transformers.js y no se guardan dos veces.