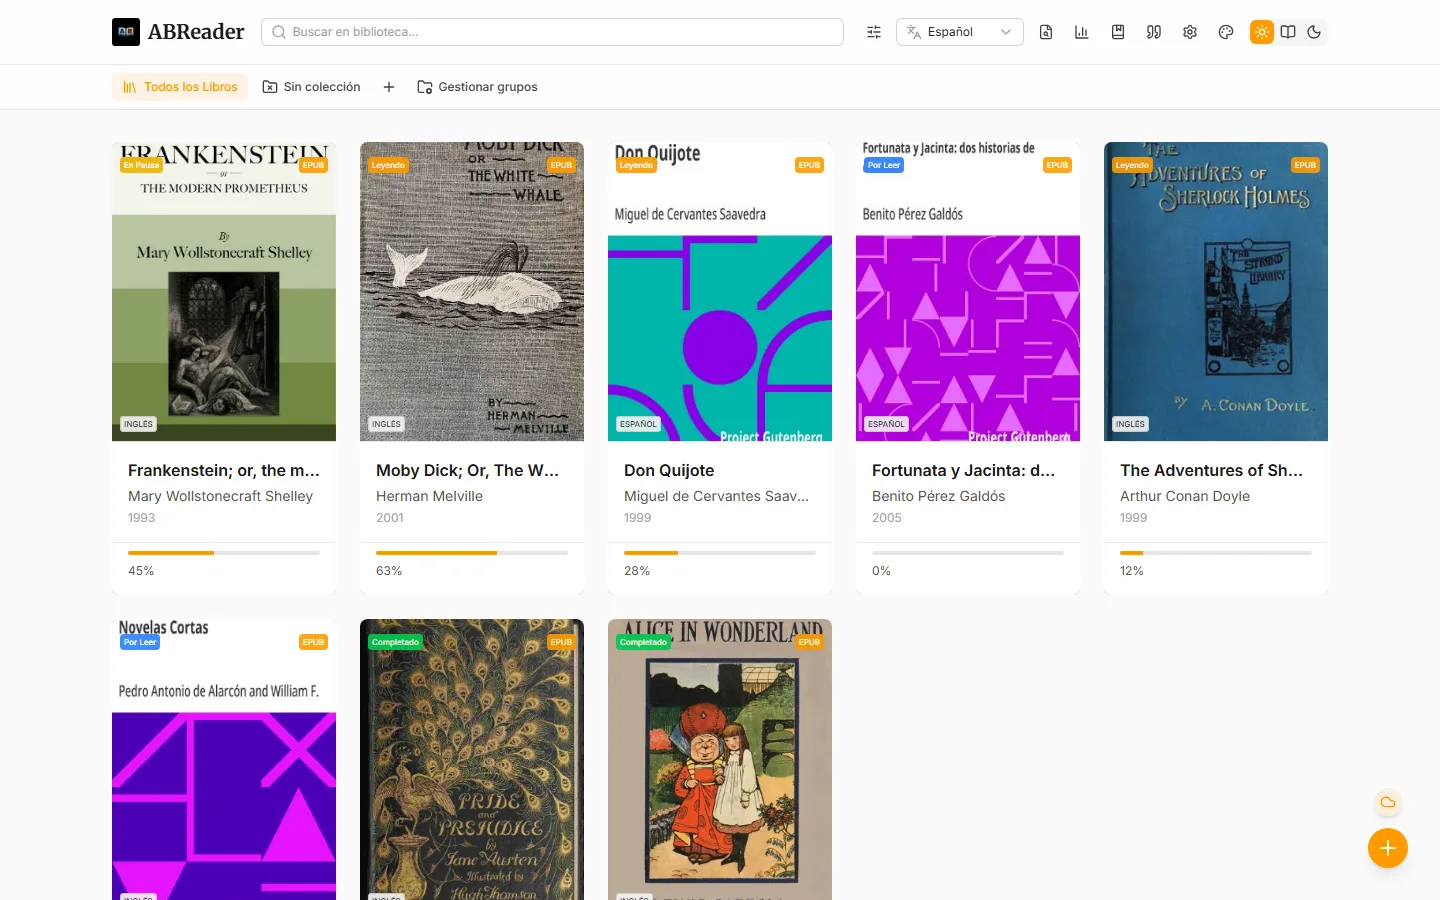
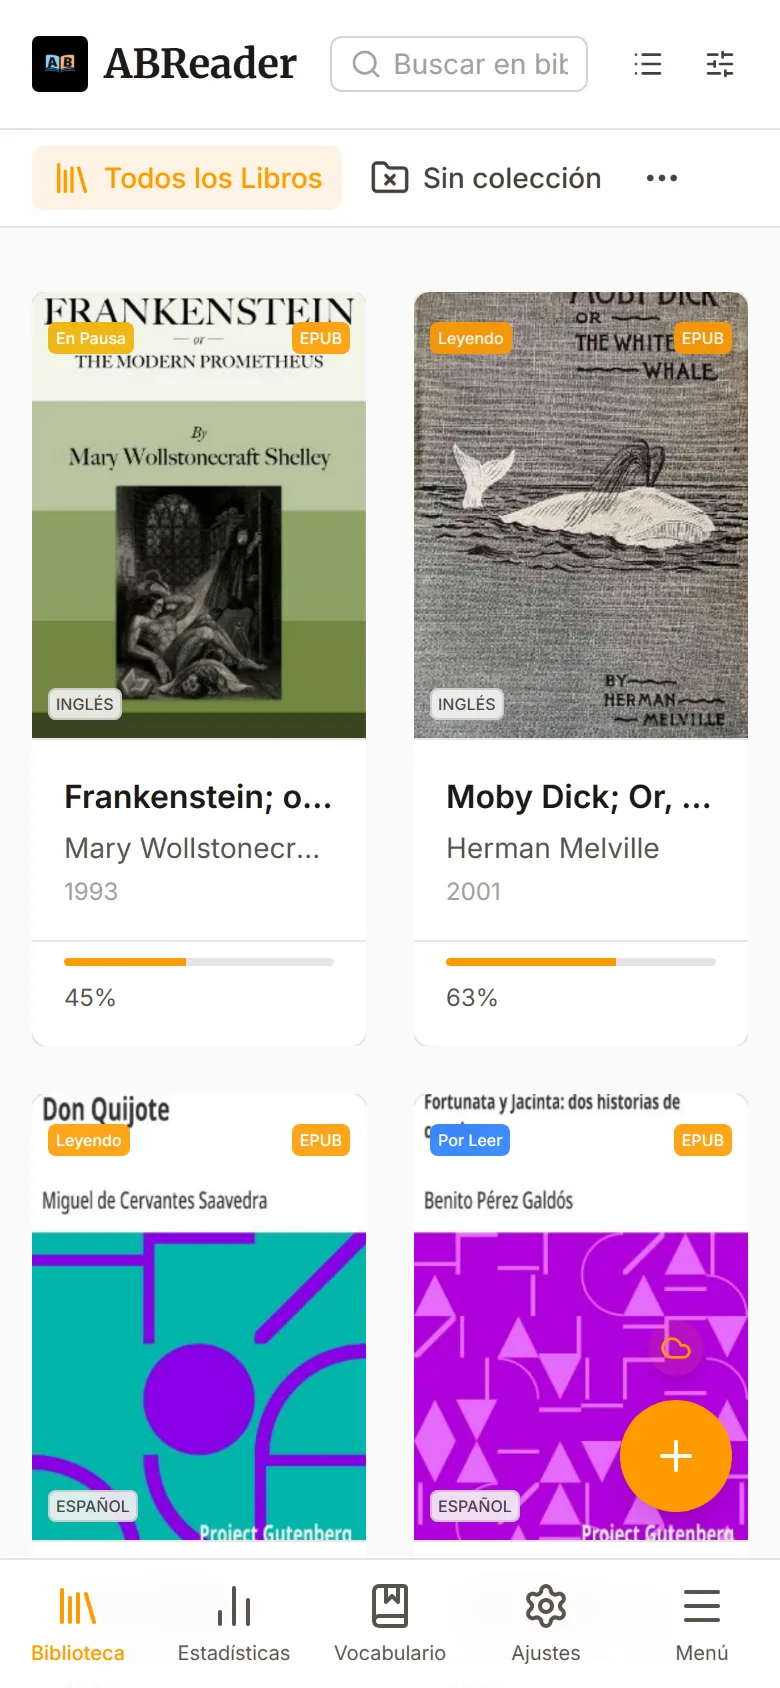
- Biblioteca local. Colecciones, búsqueda, estados de lectura y estadísticas con rachas y mapa de actividad.
- Once formatos. ePub, PDF, MOBI, FB2, DOCX, CBZ, CBR, DjVu, HTML, Markdown y TXT.
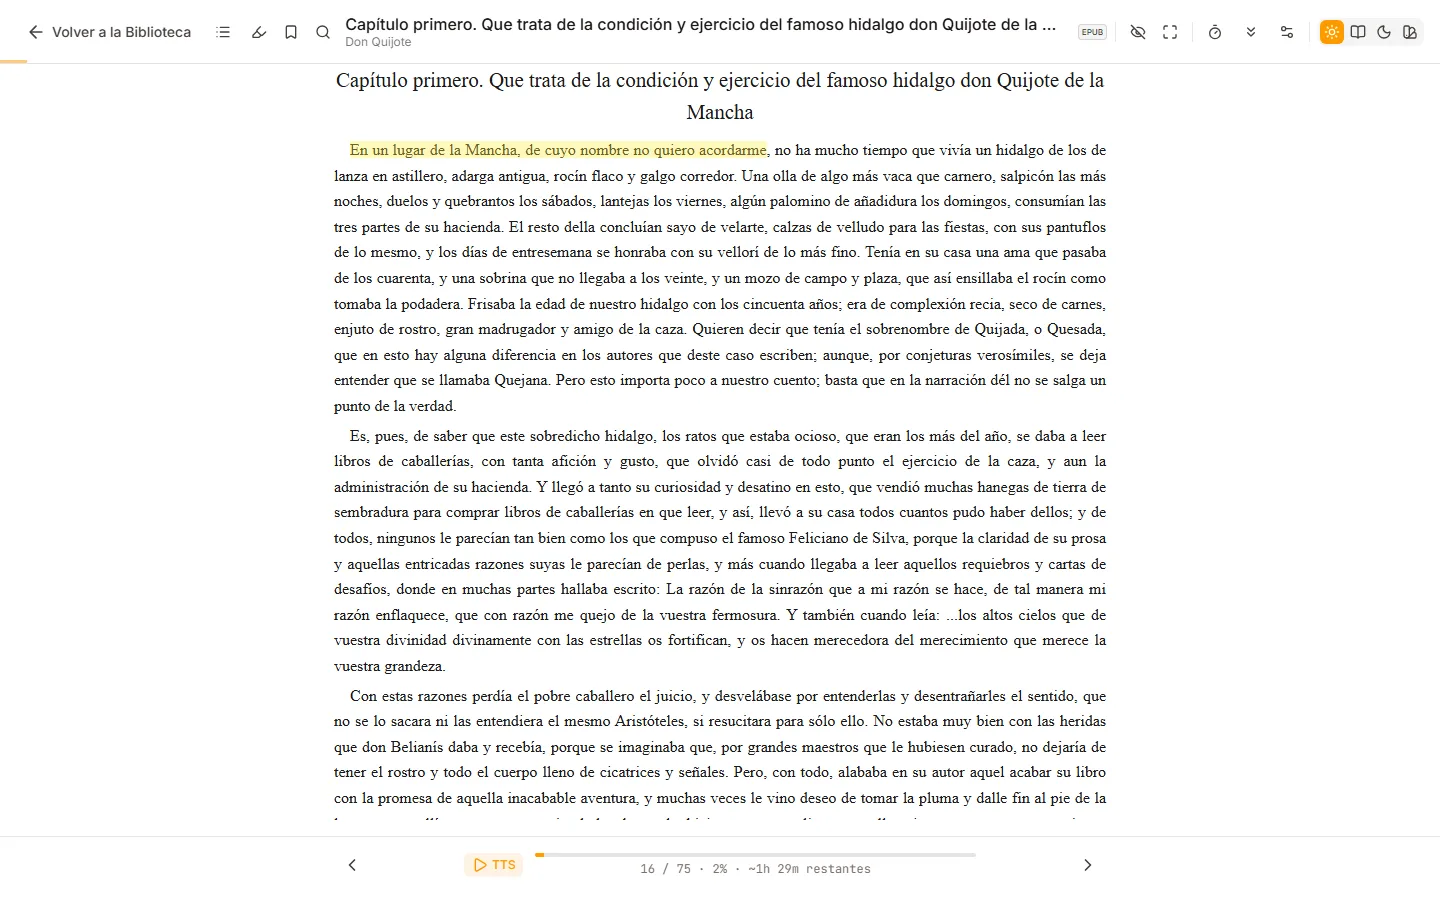
- Lectura cómoda. Temas, tipografías del sistema, modo paginado o continuo y atajos configurables.
- Subrayados y notas. Resaltados con notas y citas que se pueden exportar.
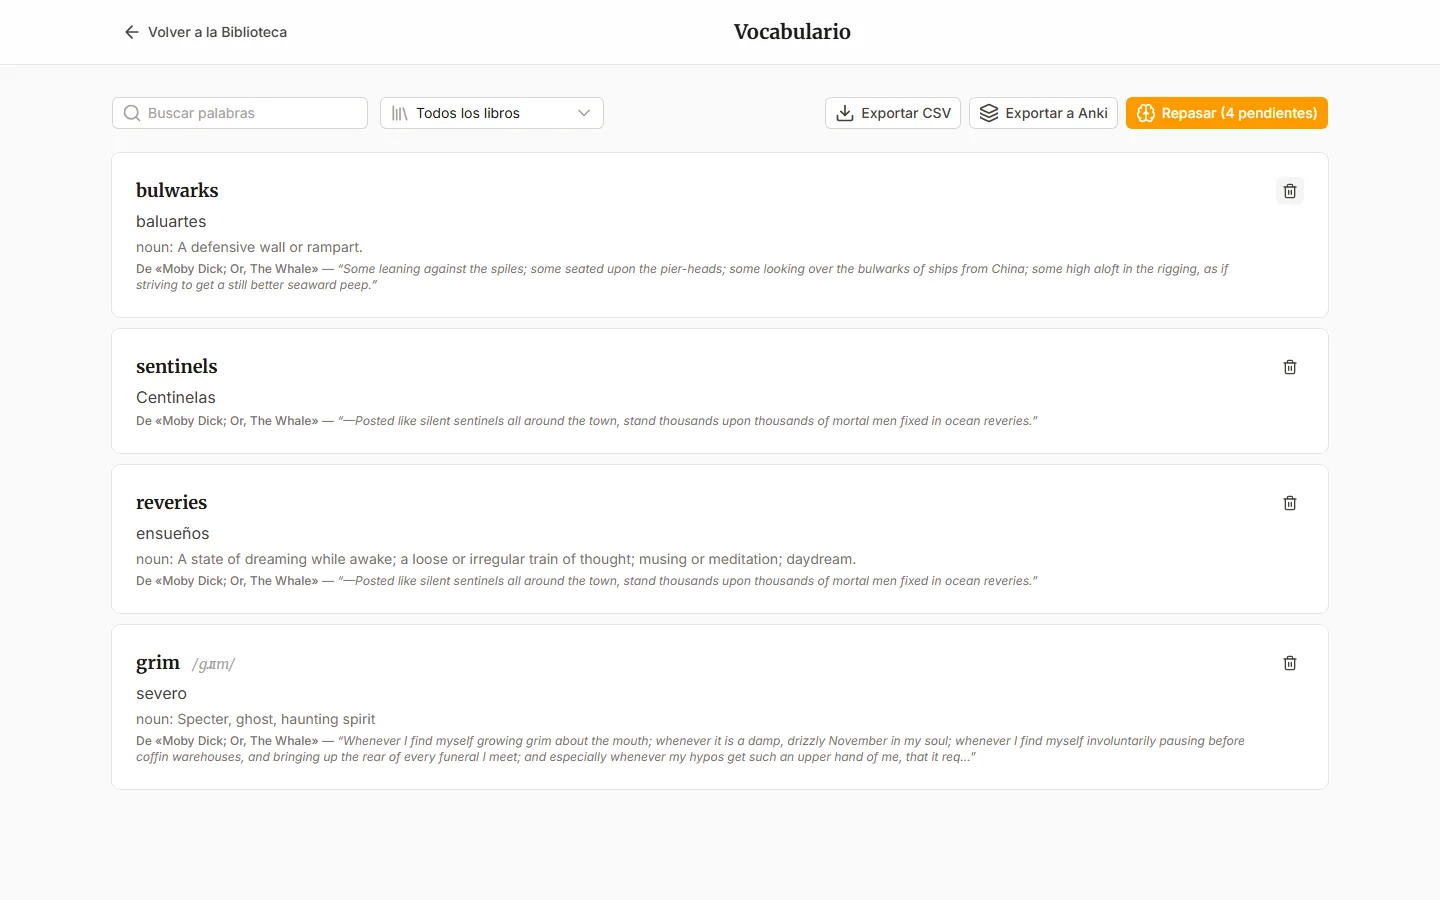
- Aprender idiomas. Diccionario y traducción al seleccionar una palabra, y tarjetas de vocabulario con repaso espaciado.
- Escuchar el libro. Lectura en voz alta frase a frase, con resaltado, también sin conexión.
- Sincronización opcional. Los datos se guardan en el Google Drive del usuario, no en un servidor mío.
- Web y escritorio. Funciona en el navegador como PWA y en Windows, macOS y Linux como app nativa. La interfaz está en 9 idiomas.
No hay servidor propio. Libros, progreso, marcadores y estadísticas viven en IndexedDB y en OPFS, el sistema de archivos privado del navegador, o en disco cuando corre como app de escritorio. Eso no elimina los problemas de backend, los traslada al cliente: merge entre dispositivos, borrados que se propagan, archivos de cientos de megas, cuotas de almacenamiento y OAuth con Google Drive.
La interfaz usa composables, los composables usan repositorios y handlers de formato, y solo dos ficheros tocan IndexedDB. La lógica que no necesita reactividad (merge, calendario de repasos, validaciones) son funciones puras, testeables sin montar componentes e importables desde un Web Worker.
Cada formato implementa la misma interfaz (patrón Strategy) y declara qué sabe hacer: índice, zoom, modo continuo. El lector nunca pregunta qué formato tiene delante, y la librería de cada uno (pdf.js, el parser de MOBI, el de DjVu) solo se descarga al abrir un libro de ese tipo.
La síntesis de voz local encadena modelos ONNX dentro de Web Workers, usa WebGPU cuando hay GPU y WASM cuando no, y guarda los modelos en OPFS con una descarga atómica. Si el modelo aún no está listo, la lectura usa la voz del navegador y vuelve sola a la local cuando lo está.
La versión de escritorio usa Tauri en lugar de Electron: el WebView del sistema en vez de empaquetar Chromium, así que el instalador es pequeño y consume menos memoria. Las diferencias de plataforma están aisladas en dos plugins.
- Libros borrados que «resucitaban» al sincronizar. El borrado no dejaba rastro, así que otro dispositivo volvía a añadir el libro. Lo resolví con marcas de borrado explícitas que viajan en la sincronización, partiendo de una regla: que algo falte en el remoto no significa que se haya borrado.
- Exportar cientos de MB sin quedarse sin memoria. La exportación construía todo en memoria. Ahora se genera en streaming y la subida a Drive es reanudable.
- La posición de lectura se perdía al redimensionar. El resaltado de la lectura en voz alta alteraba las posiciones que guarda epub.js. Ahora se guarda la posición del bloque que contiene la frase, que no cambia.
- Un fallo de build que ningún check detectaba. Un cambio en el worker de voz pasaba lint, tests y typecheck pero rompía el build de producción. Además de arreglarlo, añadí el build de producción al CI en cada push.