OCR Web
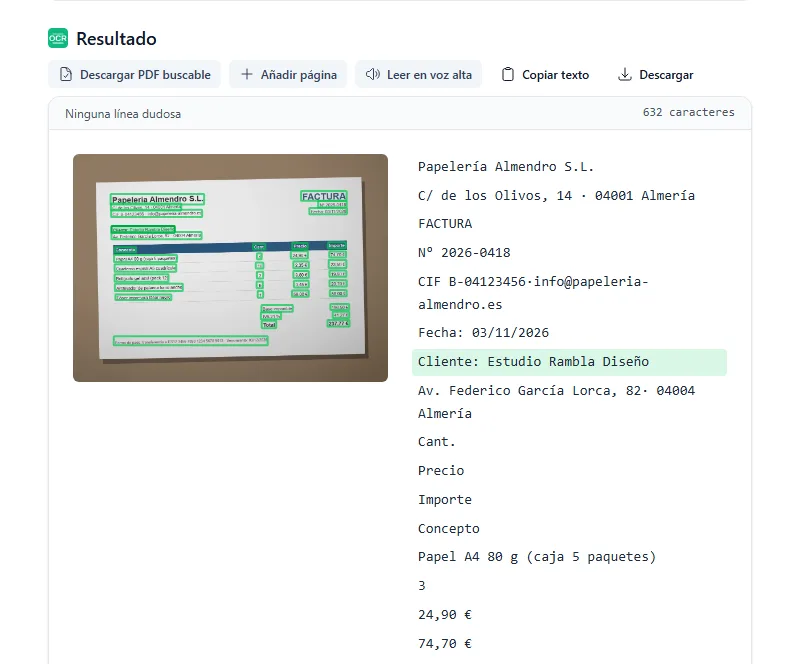
Reconocimiento de texto en imágenes y PDF que funciona entero en el navegador, también en japonés y chino. Tres motores (PP-OCRv6, su versión ligera y Tesseract.js), resultado enlazado con la imagen y editable, líneas dudosas marcadas, documentos de hasta 100 páginas y PDF buscable. Las imágenes no salen del dispositivo y, tras la primera descarga, funciona sin conexión. Lo empecé para investigar el OCR en el navegador.
- error por carácter con PP-OCRv6
- 2 %
- error por carácter con PP-OCRv6
- idiomas de OCR
- 6
- idiomas de OCR
- tests
- 408
- tests
- imágenes enviadas
- 0
- imágenes enviadas
Qué hace
- Tres motores. PP-OCRv6, el de más calidad, con un único modelo para los seis idiomas; su versión ligera, más rápida; y Tesseract.js, que descarga solo el idioma que eliges.
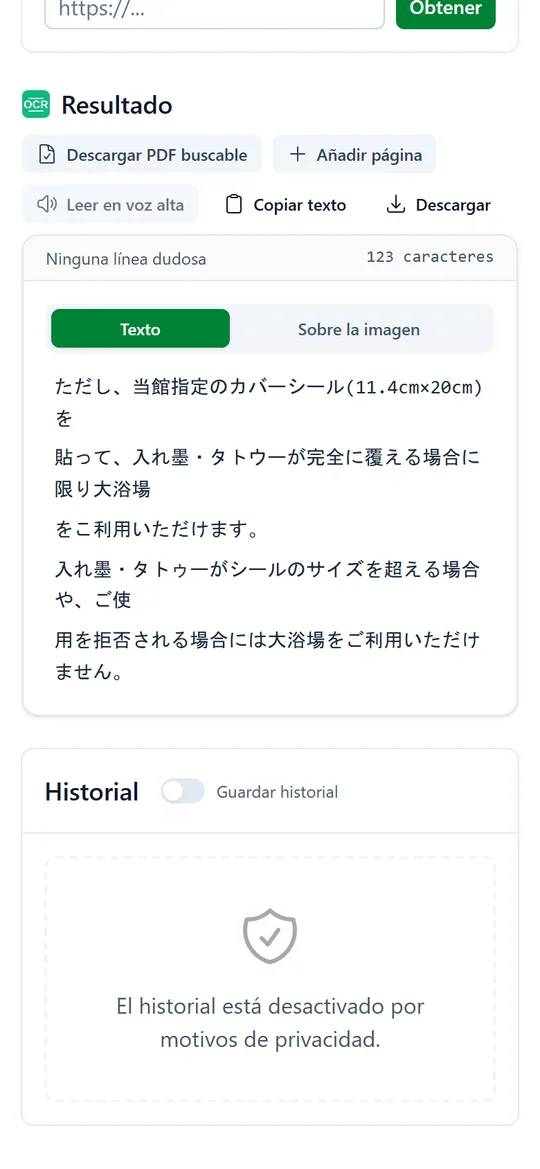
- Japonés y chino de verdad. En las pruebas con fotos y capturas reales, PP-OCRv6 se equivoca en un 3 % de los caracteres en japonés y un 4 % en chino. Tesseract, en un 33 y un 50 %.
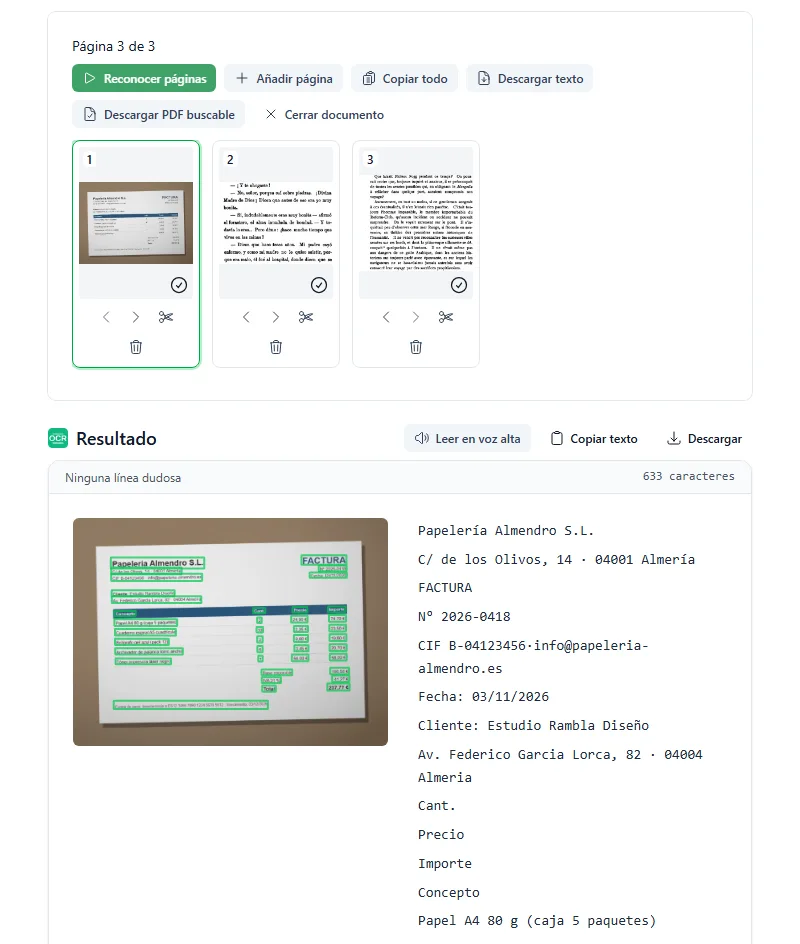
- Un resultado que se puede comprobar. La imagen con una caja sobre cada línea, al lado del texto. Al pasar por una línea se resalta en los dos sitios. Las líneas dudosas se marcan, y cualquier línea se corrige antes de copiar.
- Documentos. PDF o varias imágenes, hasta 100 páginas, reconocidas una a una. Se descarga el texto o un PDF buscable con las páginas originales intactas y una capa de texto invisible.
- Cómodo en el móvil. Hacer una foto, compartir una imagen desde la galería o pegarla con
Ctrl+Ven cualquier parte. Se puede usar entera con el teclado y con lector de pantalla. - Privada. Las imágenes y el texto no salen del navegador, no hay analítica y el historial está apagado por defecto. Lo único que se descarga son los motores, la primera vez que se usan.
Cómo está hecho
Un benchmark antes de tocar nada
Antes de cambiar de motor, monté un conjunto de evaluación con imágenes reales de dominio público y sintéticas, y un script que mide el error por carácter (CER) de cada motor en cada idioma y tipo de imagen. Cada decisión posterior, desde el motor por defecto hasta los umbrales de las líneas dudosas, sale de ahí.
PP-OCRv6 en el navegador
El SDK oficial de PaddleOCR se carga en tiempo de ejecución desde jsDelivr y corre en un Web Worker con ONNX Runtime en WebAssembly, con un solo hilo. Así no hacen falta las cabeceras especiales que GitHub Pages no permite. Los modelos vienen de Hugging Face, fijados a una revisión concreta.
PDF buscable sin servidor
La capa de texto usa la misma fuente «sin dibujo» de 572 bytes que usa Tesseract. El texto se escribe en modo invisible sobre las páginas originales, que se copian sin tocar.
Problemas que resolví
- Un motor obsoleto. El Paddle.js original solo sabía chino y se quedaba «inicializando» para siempre. PP-OCRv6 bajó el error del 16 % de Tesseract a un 2 %.
- Los modelos no descargaban. El SDK los pide a un servidor de Baidu que no respondía desde mi red. Los mismos modelos están en Hugging Face como archivos sueltos, y los empaqueto en un
.taren memoria, que es lo único que acepta el SDK. - Páginas a dos columnas. Tesseract leía las líneas de lado a lado y mezclaba las columnas: un 62 % de error. Cortando por los huecos entre palabras, baja al 0,2 %.
- Fotos torcidas. Con una página girada unos grados, PP-OCRv6 mezclaba las líneas entre filas: un 31 % de error. Ahora se mide la inclinación y se endereza antes de leer, y baja al 1,2 %.
- Escritura a mano. Probé Florence-2 y TrOCR con una regla fijada antes de medir. Ninguno mejoraba a PP-OCRv6, así que no entró ninguno.