Cómo construí este blog: estático, sin servidor y sin coste de hosting
Por qué elegí Nuxt y Markdown en lugar de WordPress, cómo separo el código privado del sitio publicado, qué se rompió en el primer despliegue y cómo funcionan los artículos programados, el buscador sin servidor y los filtros.
Quería un sitio donde enseñar mis proyectos y contar cómo están hechos por dentro. No pedía mucho: que cargara rápido, que no dependiera de un servidor ni de una base de datos, y que publicar un artículo consistiera en escribir un Markdown y hacer push.
Aquí explico qué elegí, por qué, y lo que se rompió la primera vez que lo desplegué, que fue más de lo que esperaba.
Por qué no WordPress
Trabajo con WordPress a menudo, así que era lo primero que me venía a la cabeza. Lo descarté porque para un blog personal se me hacía enorme: servidor PHP, base de datos, actualizaciones de seguridad y un hosting que pagar cada mes. Todo eso para servir páginas que solo cambian cuando yo publico algo, no cuando alguien entra a leerlas.
Un sitio estático hace lo mismo con muchas menos piezas. GitHub Pages lo aloja gratis, porque solo tiene que servir archivos. Cada página ya es HTML generado, así que no hay consultas ni renderizado en el servidor. No hay panel de administración que atacar ni plugins que actualizar un domingo por la tarde. Y los artículos son ficheros .md que viven en Git junto al código, con su historial.
El stack es Nuxt 4 con Nuxt Content para el Markdown y Tailwind CSS v4 para los estilos. npm run generate prerenderiza todas las rutas a HTML estático, incluidos el feed RSS y el sitemap.
Código privado, sitio público
El código del blog está en un repositorio privado. Lo que se publica va a otro, blog-public, que solo contiene el resultado de la generación. Es el mismo patrón que uso en casi todos mis proyectos: el desarrollo en un repo privado y un repo -public que solo sirve la versión compilada.
El sitio es público, pero el código no tiene por qué serlo. El repo público además queda limpio, sin historial de código, ramas ni configuración, solo con archivos listos para servir. Y si algún día quiero alojarlo en otra cuenta, puedo hacerlo sin dar acceso al código.
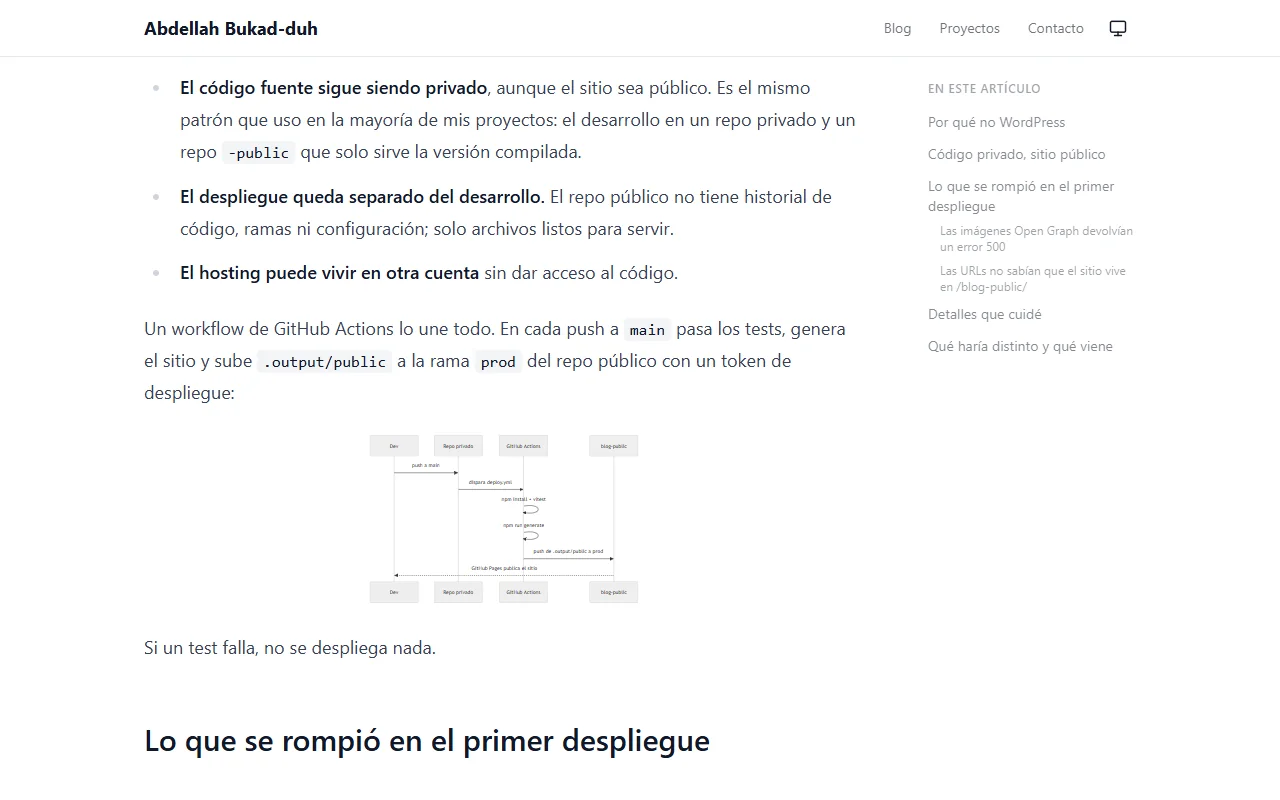
Lo que conecta los dos repos es un workflow de GitHub Actions. En cada push a main pasa los tests, genera el sitio y sube .output/public a la rama prod del repo público con un token de despliegue:
Si falla un test, no se publica nada.
Lo que se rompió en el primer despliegue
En local funcionaba todo. En CI, la generación falló a la primera, y por dos sitios distintos.
Las imágenes Open Graph devolvían un error 500
Cada artículo genera su propia imagen para cuando se comparte en redes, con el módulo nuxt-og-image. Durante el prerender esas rutas respondían con un 500 y la generación se abortaba entera.
Reproduje el fallo en local con las mismas variables de entorno que el CI, y resultó que eran dos problemas, uno detrás de otro:
- La plantilla de la imagen venía de un paquete de la comunidad. En desarrollo se resuelve sola, pero para producción el módulo exige tenerla copiada en el proyecto. La copié a
app/components/OgImage/BlogPost.takumi.vue, y de paso ahora puedo adaptarla al diseño del blog. - Con la plantilla en su sitio, seguía fallando. Faltaba el motor que convierte la plantilla en imagen,
@takumi-rs/core, que no se instala con el módulo. Lo añadí como dependencia y por fin generó.
Las URLs no sabían que el sitio vivía en /blog-public/
Hoy el blog tiene dominio propio y se sirve desde la raíz, pero en aquel primer despliegue GitHub Pages lo servía en abdell1999.github.io/blog-public/. Nuxt lo resuelve con NUXT_APP_BASE_URL=/blog-public/, aunque no todo lo que genera URLs absolutas se entera.
El RSS enlazaba a abdell1999.github.io/posts/..., sin la subcarpeta, porque el endpoint construía las URLs solo con la URL del sitio. Ahora combina las dos:
const siteUrl = config.public.siteUrl
  ? withoutTrailingSlash(joinURL(config.public.siteUrl, config.app.baseURL))
  : ''
El sitemap tenía su propio lío. Incluía la ruta /blog-public como si fuera una página más, y encima la primera configuración del CI metía la subcarpeta también en la URL del sitio, así que salía duplicada. Lo arreglé dejando la URL del sitio en la raíz del dominio y excluyendo la ruta base del sitemap.
Si el sitio no se va a servir desde la raíz, conviene probar la generación con esa configuración desde el primer día. Yo lo descubrí en el primer despliegue, que es el peor momento para descubrir nada.
Algunos detalles
Hay cosas pequeñas en las que sí me paré un rato.
El tema claro y oscuro no toca ningún componente. Los colores son variables CSS definidas dos veces, una para :root y otra para .dark, y los componentes solo usan var(--fg), var(--accent) y compañía. Cambiar de tema es cambiar una clase en <html>. Por defecto sigue la preferencia del sistema.
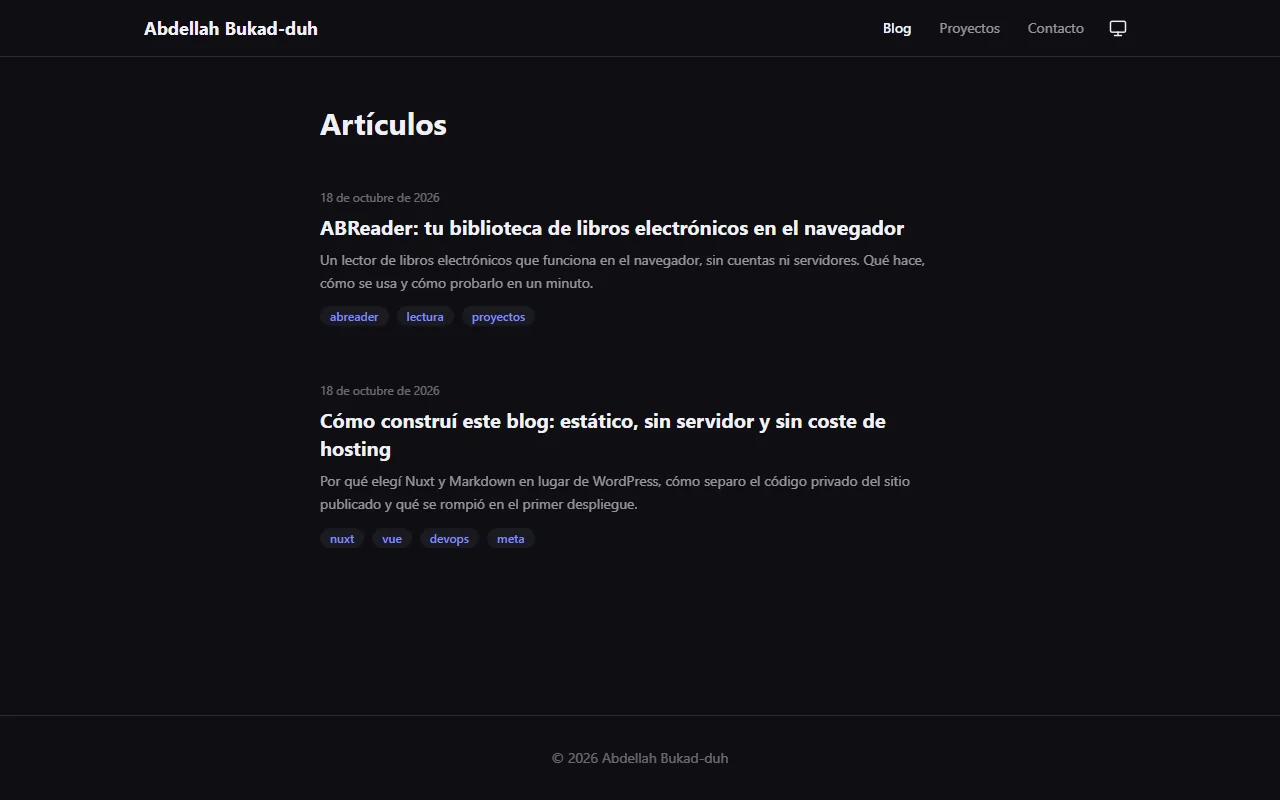
El índice lateral sigue la lectura. Nuxt Content ya genera el árbol de encabezados de cada artículo; el índice lo pinta y usa un IntersectionObserver para marcar la sección que estás leyendo, en vez de escuchar el scroll en cada frame.
Los bloques de código y los diagramas pasan por un único componente. Si el bloque es mermaid, dibuja el diagrama en el navegador, como el del despliegue de más arriba. Si no, muestra el código con un botón para copiarlo.
Los componentes con algo de lógica (el índice, los bloques de código, el selector de tema, las tarjetas y las etiquetas) tienen tests con Vitest, y el CI los ejecuta antes de cada despliegue.
Lo que ha crecido desde entonces
El blog empezó con una lista de artículos, las páginas de proyecto y el RSS. Con el contenido llegaron otras necesidades, y cada una tuvo que resolverse sin añadir un servidor.
Artículos programados
Escribo varios artículos seguidos, pero prefiero publicarlos de uno en uno. Quería dejarlos en el repositorio con su fecha y olvidarme. Que salieran solos ese día.
Un sitio estático no tiene a nadie despierto a medianoche para publicar nada, así que el trabajo se reparte entre la build y el CI:
- La build de producción deja fuera los artículos con fecha futura. Al arrancar,
content.config.tslee el frontmatter de cada Markdown y excluye de la colecciónpostslos que tienen una fecha posterior a hoy en Madrid. Como todo lo demás sale de esa colección, el artículo no aparece en la portada, ni en el RSS, ni en el buscador, ni enllms.txt. - Un cron diario vuelve a desplegar. El workflow tiene un
scheduleque corre justo después de medianoche, hora de Madrid. Antes de construir nada busca si algún artículo tiene la fecha de hoy. Si no hay ninguno, termina sin desplegar y no gasta minutos de CI. - La URL del artículo ya existe antes de tiempo. Hay una segunda colección,
postSummaries, con el título, la descripción y la fecha de todos los artículos, también los programados. Si alguien abre el enlace antes del día (porque lo compartí antes o porque lo ha adivinado), la página no da un 404: dice cuándo sale. Esa página llevanoindexpara que Google no la guarde así.
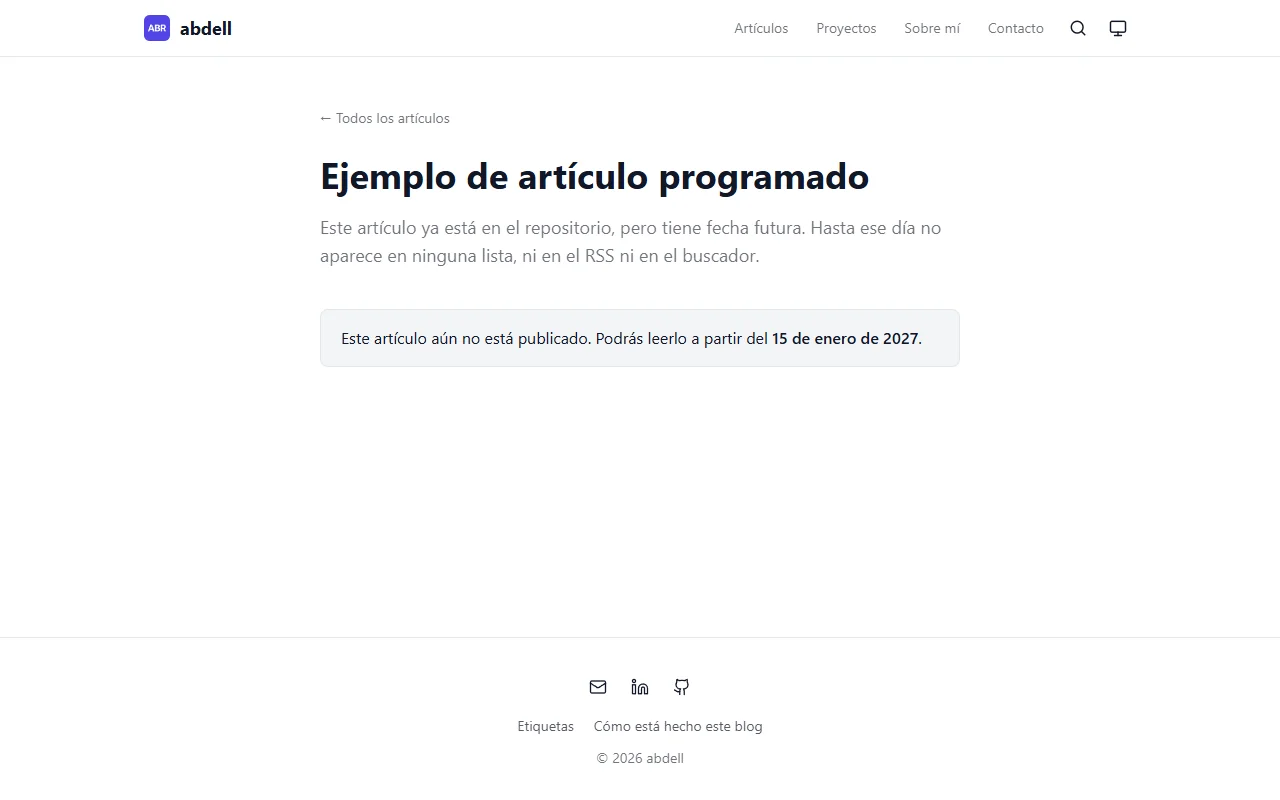
En desarrollo, npm run dev enseña también los programados, para poder revisarlos como quedarán.
Un buscador sin servidor
Buscar sin backend significa llevar el índice al navegador. Durante la generación, una ruta del servidor de Nuxt (server/routes/search.json.ts) recorre artículos y proyectos, junta el texto de cada sección y lo escribe en un único search.json. Esa ruta solo se ejecuta al compilar. En producción es un fichero estático más.
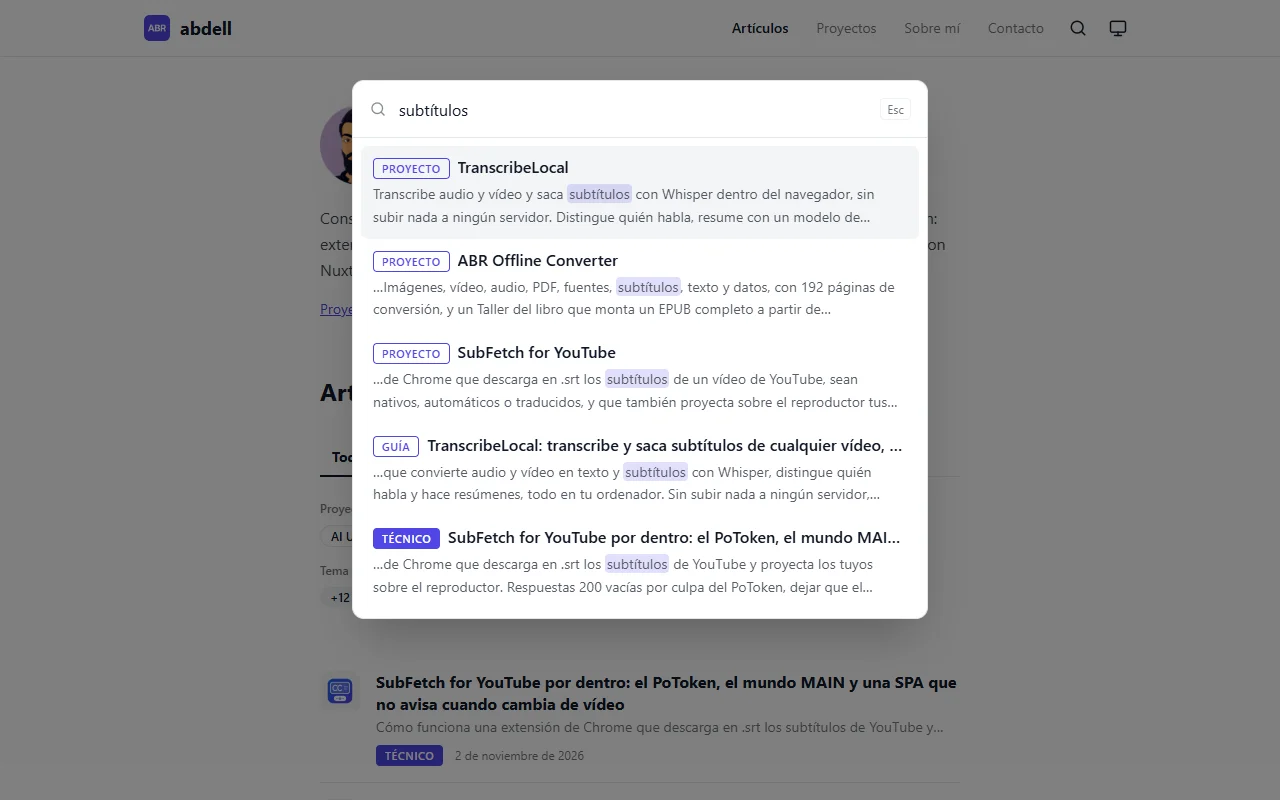
El buscador se abre con el icono de la lupa o con Ctrl+K. Descarga el índice la primera vez que lo abres y a partir de ahí busca en local. Ignora tildes y mayúsculas, así que «subtitulos» encuentra «subtítulos», y resalta el fragmento donde aparece el término. Los bloques de código y los diagramas quedan fuera del índice porque llenaban los resultados de ruido.
Guías, técnicos y filtros
Casi cada proyecto tiene dos artículos: una guía para quien quiere usarlo y otro técnico sobre cómo está hecho. Son lecturas muy distintas, así que el tipo es un campo obligatorio del frontmatter y cada artículo lo enseña antes del título. Si se me olvida ponerlo, falla un test y el artículo no se despliega.
Con más de veinte artículos hizo falta filtrar. La portada filtra por tipo, por proyecto y por tema, y la página de proyectos por tecnología. Los filtros viven en la URL (/?tipo=tecnico&tema=ia), así que una búsqueda filtrada se puede compartir o guardar. Se calculan a partir de las etiquetas: un artículo pertenece a un proyecto si lleva la etiqueta de ese proyecto.
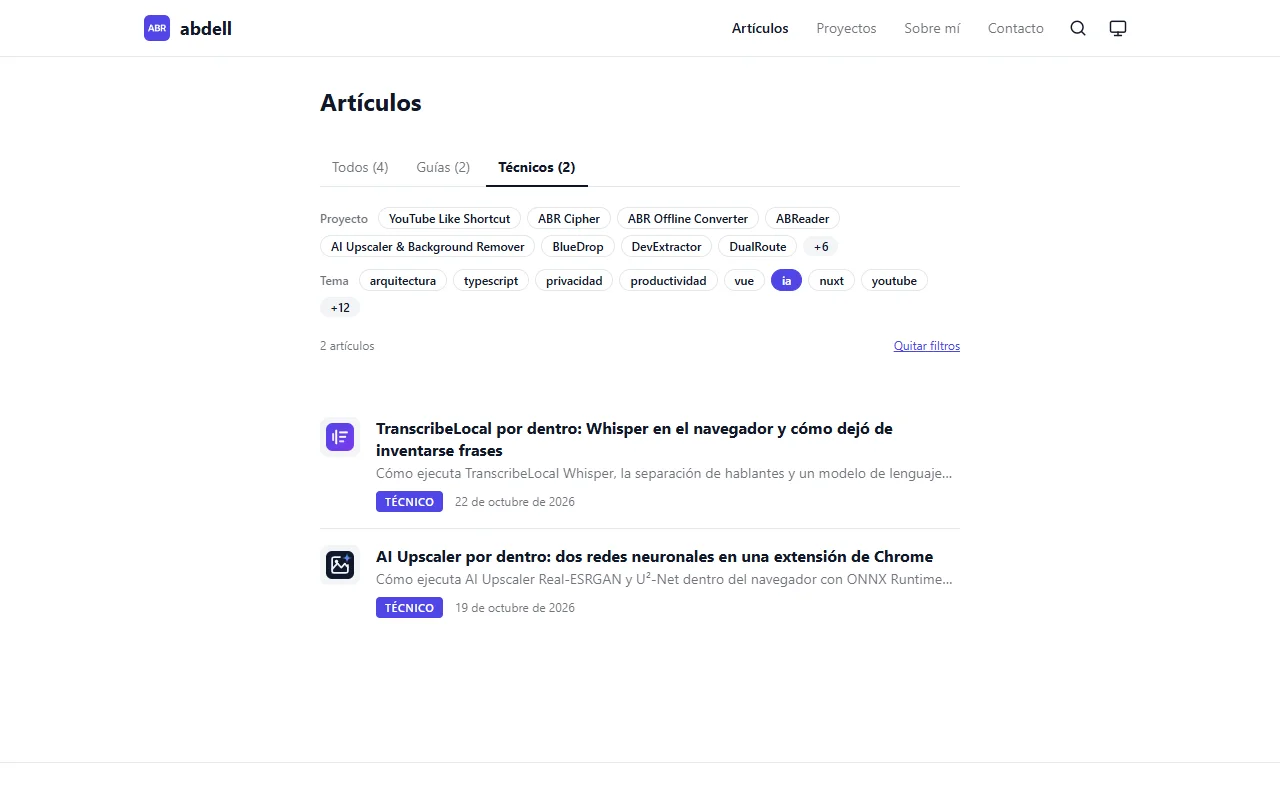
Al principio la lista enseñaba la descripción completa y las etiquetas de cada artículo, y en pantalla cabían dos o tres. Ahora cada artículo ocupa una fila con el icono de su proyecto, el título, una línea de descripción, el tipo y la fecha. El icono sale de la ficha del proyecto, así que la guía y el artículo técnico del mismo proyecto se reconocen de un vistazo. Los artículos que no son de ningún proyecto llevan la inicial del título.
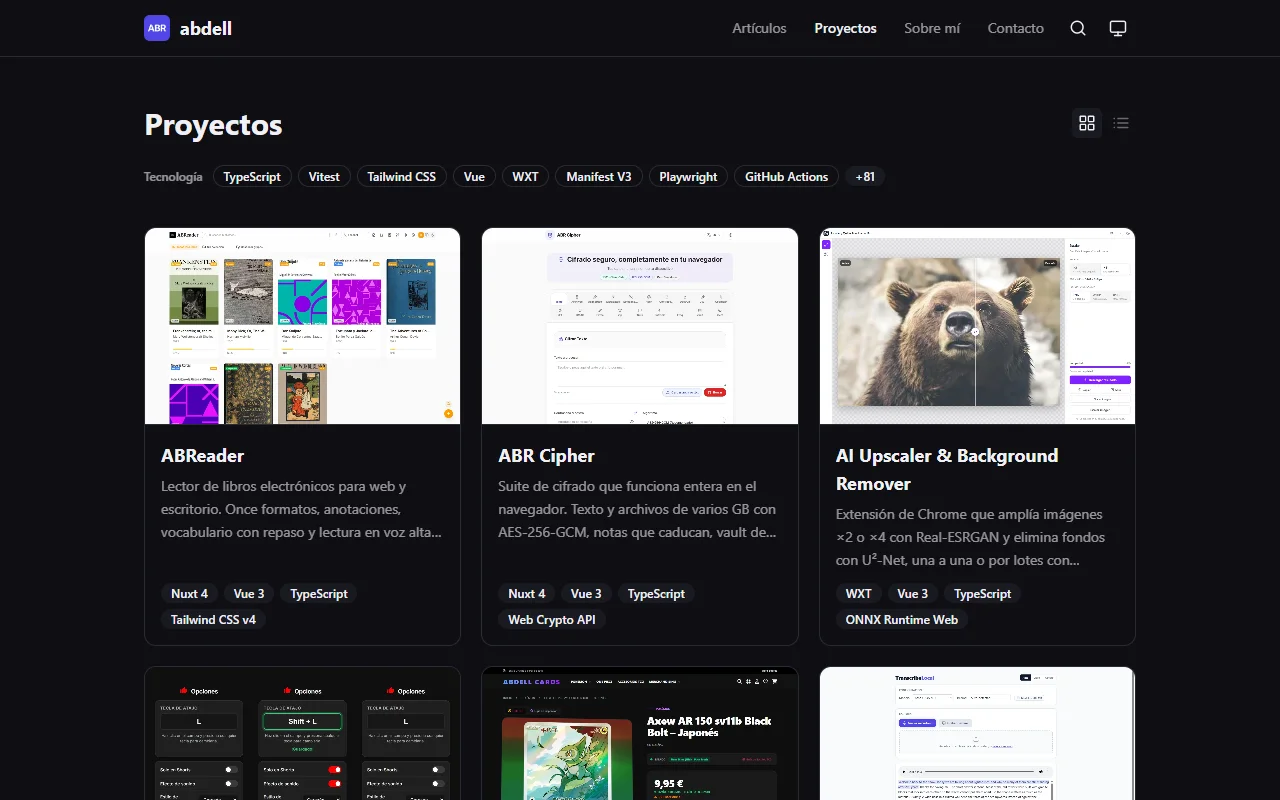
La página de proyectos tiene dos vistas, rejilla con capturas o lista, y recuerda cuál prefieres.
Una 404 que no es un callejón sin salida
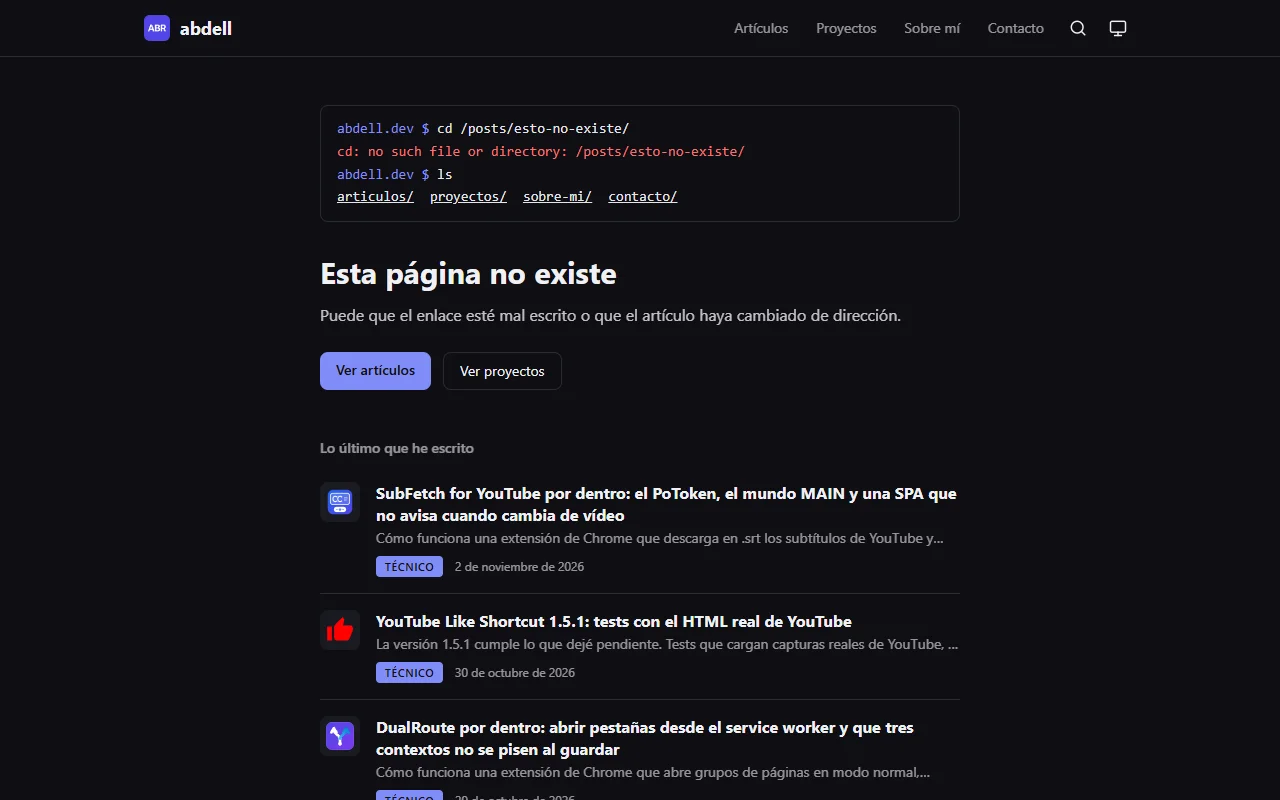
La página de error por defecto de Nuxt estaba en inglés, sin la cabecera del sitio y con un único enlace. La reemplacé por una terminal que intenta hacer cd a la dirección que has pedido, falla y lista las secciones del blog. Debajo aparecen los tres últimos artículos, para quien llega por un enlace roto desde LinkedIn o Google. En GitHub Pages esa página se sirve como 404.html y devuelve un 404 de verdad.
Dominio propio y SEO
El blog dejó la subcarpeta de GitHub Pages y ahora se sirve en abdell.dev, con un fichero CNAME en public/. Eso me ahorró los problemas de la ruta base del primer despliegue, aunque el código sigue soportándola.
Lo demás son detalles que no se ven pero cuentan. Cada página tiene su URL canónica con la barra final, que es la que GitHub Pages sirve sin redirección. Hay datos estructurados: un Person y un WebSite en todas las páginas, y un BlogPosting en cada artículo que apunta a esa misma persona. Cada artículo genera su imagen para redes con su título, su tipo y su fecha. Y hay un llms.txt que resume quién soy, los proyectos y los artículos publicados para los asistentes de IA. Los programados no aparecen ahí hasta su día.
Qué haría distinto
Generaría el sitio con la configuración de producción desde el principio, subcarpeta incluida. Los dos fallos del despliegue se arreglaron rápido, pero solo aparecían en ese escenario y yo no lo había probado.
También metería en el CI una comprobación de enlaces sobre el HTML generado. Los tests de componentes no ven un enlace roto ni una URL a la que le falta la subcarpeta, y eso es justo lo que falló. De momento tengo un test que comprueba que cada imagen que cito en un artículo o en un proyecto existe de verdad en public/.
Lo siguiente
Cada proyecto ya tiene su página, con capturas, enlaces, una guía de uso y un artículo técnico. Lo que viene es más de lo mismo: proyectos nuevos y algún artículo que no es de ninguno. Si quieres saber cuándo sale el siguiente, el blog tiene RSS.